Liczy się każda milisekunda
(Autorzy)
Jan Wawszczak, Paweł Budzianowski
Nasze roboty wykonują pętle sterowania z częstotliwością do 100 Hz: co 10-20 milisekund system odczytuje stany przegubów i klatki z kamer, a następnie wysyła kolejne polecenie. Spóźnione dane mają fizyczne konsekwencje: szarpnięcie ramienia, chybiony chwyt, epizod, którego nie da się użyć do treningu.
Przy większych i mocniejszych modelach przeniesienie inference do chmury dodatkowo obciąża budżet latencji. W tym wpisie opisujemy, jak nasz stack jest zbudowany wokół tego ograniczenia, od zbierania danych po inference, łącznie z uruchamianiem inference na stacku Tenstorrent z własnymi kernelami dla maksymalnej wydajności.
- (Pętla sterowania)
- 100 Hz
- (Mediana obiegu)
- 70,6 ms
- (Maks. obiegu)
- 71,2 ms
- (RTT sieci)
- 0,7 ms
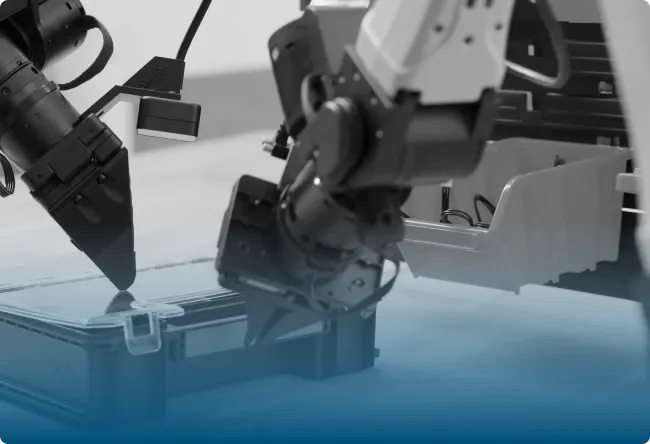
(Rys. 01) Obsługa płasko złożonego pudełka na stanowisku dwuręcznym. 
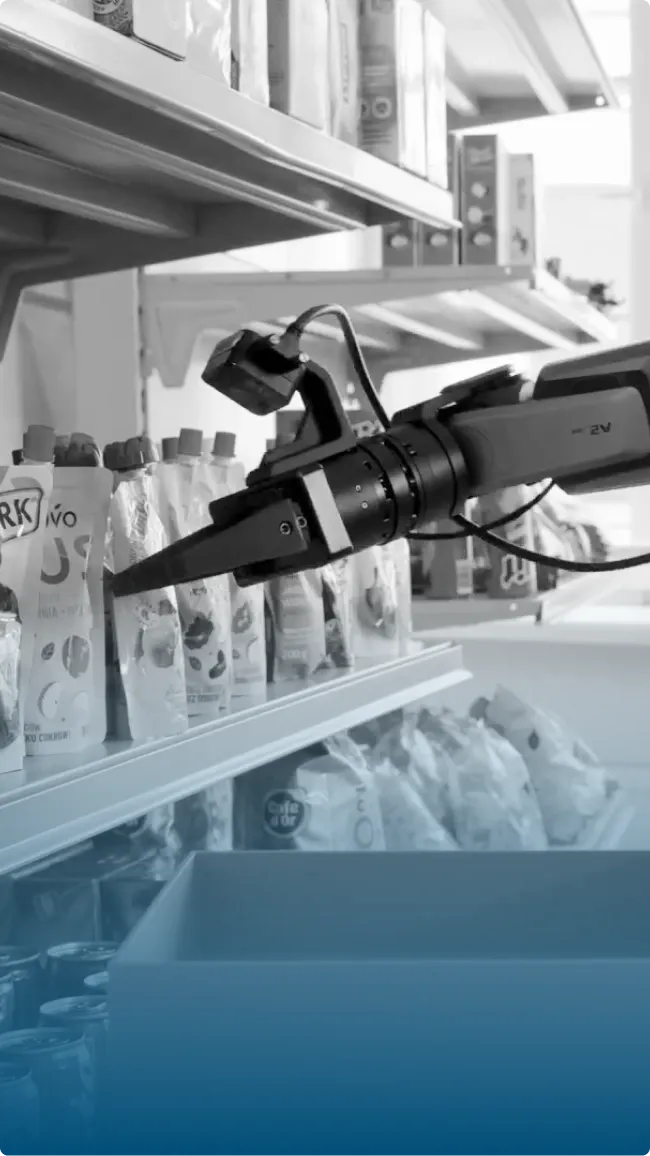
(Rys. 02) Kompletacja zamówień: obiekt odkształcalny. 
(Rys. 03) Kompletacja zamówień: obiekt sztywny. 
(Rys. 04) Składanie koszulki z losowego stanu początkowego.
Pętla sterowania
Fundamentem pętli sterowania jest sprzęt. Ramiona leader są odpytywane z częstotliwością sterowania przez magistralę szeregową, a ramiona follower sterowane przez CAN 1 Mbit ze wzmocnieniami PD dostrojonymi do pętli 100 Hz. Adaptery szeregowe grupują odczyty z timerem latencji 16 ms, który pochłania większość taktu sterowania wewnątrz kernela; reguła udev ustawia go na 1 ms na każdym stanowisku. Kamery pracują w 60 fps, a każda klatka ma budżet wieku równy dwóm okresom klatki: starsza klatka jest traktowana jako błąd, a nie jako dane.
Pracę wymagającą dużej mocy obliczeniowej trzymamy poza pętlą. Zapis zbiorów danych i kodowanie wideo odbywają się w osobnym procesie rejestratora. Klatki trafiają do niego bez serializacji, przez pulę slotów w pamięci współdzielonej; kolejka między procesami przenosi wyłącznie indeksy slotów. Epizody są synchronizowane co noc i przechodzą przez filtry jakości opisane we wcześniejszym wpisie.
Izolacja ścieżki krytycznej
Rdzenie platformy docelowej są podzielone: system operacyjny i procesy krytyczne czasowo (pętla sterowania, inference, rejestrator) działają każdy na własnym zestawie rdzeni, a host jest dostrojony od początku do końca tak, by nic nie wywłaszczało pętli, od harmonogramowania przez zarządzanie pamięcią po runtime ML. Jedno urządzenie to jeden proces, a procesy działają w modelu crash-only. Nadzór przejmuje systemd: każdy sterownik podtrzymuje watchdog przy każdej opublikowanej próbce, więc zawieszona lub odłączona kamera przestaje go zasilać i w ciągu kilku sekund zostaje zrestartowana, a reszta systemu działa dalej.
W obrębie hosta procesy komunikują się przez iceoryx2, transport zero-copy w pamięci współdzielonej. Jego wydajność nie zależy od liczby subskrybentów, więc podłączenie podglądu, obserwatora topologii czy rejestratora do debugowania do strumienia z kamery nie wpływa na pętlę sterowania. Dzięki temu pętla może też współistnieć z procesami i usługami zbudowanymi wokół niej.
Obsługa Tenstorrent
Niedawno przenieśliśmy inference naszego modelu na stack Tenstorrent. Model działa na tt-metal, graf obliczeń jest przechwycony jako trace urządzenia, a dwie kolejki poleceń zrównoleglają pracę: gdy jedna odtwarza graf dla bieżącego żądania, druga już ładuje na kartę obrazy i tokeny kolejnej obserwacji. Największą pojedynczą poprawę wydajności przyniosła przebudowa prefillu vision-language tak, by przetwarzał wszystkie trzy widoki z kamer i prompt w jednym przebiegu na całym chipie:
| (Chunk prefillu VLM) | (Replay na urządzeniu) | (Łącznie w procesie) |
|---|---|---|
| 320 | 66,1ms | 72,3ms |
| 768 | 51,2ms | 57,6ms |
| 1024 | 41,8ms | 48,0ms |
Przy obsłudze end-to-end przez gRPC round trip wynosi 70,6 ms w medianie i 71,2 ms maksymalnie. W systemie czasu rzeczywistego liczy się najgorszy przypadek. Dla porównania: chunk pięćdziesięciu akcji przy 50 Hz odpowiada 1 sekundzie ruchu, więc pełny round trip kosztuje 5,5% jednego chunku.
Osiągnięcie płaskiego ogona rozkładu wymagało naprawienia kilku problemów typowych dla serwowania w czasie rzeczywistym. Przechwycony trace początkowo odtwarzał się na tym, co akurat znajdowało się w buforach wejściowych urządzenia, więc każdy chunk był liczony z poprzedniej obserwacji; kolejność jest teraz pokryta testem regresyjnym. Wczesne przebiegi skakały do 102 ms na p90, ponieważ host przy każdym żądaniu dwukrotnie przebudowywał 8-megabajtową tablicę kodowania pozycyjnego tylko po to, by odczytać jej niewielki fragment; cache’owanie tablicy obniżyło maksimum z 225 ms do 65,7 ms. Zmieniona implementacja skalowania obrazu sprawiła, że preprocessing skoczył z 3 ms do 140 ms, bo domyślna pula wątków biblioteki tensorowej rywalizowała z runtime’em urządzenia; ograniczenie jej do jednego wątku przywróciło 2,8 ms.
Własna konfiguracja sieci
Pętla sterowania i policy to osobne procesy połączone przez gRPC jednym ustawieniem adresu. Ten sam kod działa z policy na hoście robota albo na osobnej maszynie z akceleratorami. Roboty, stacje robocze i maszyny do inference współdzielą prywatną sieć mesh, którą kontrolujemy od początku do końca; round trip między stanowiskiem robota a maszyną do inference wynosi średnio 0,7 ms. Sam endpoint nie jest uwierzytelniany (granicą zaufania jest sieć), a serwer odmawia nasłuchu na adresie wieloznacznym.
Protokół trzyma pętlę z dala od ścieżki sieciowej. Obserwacje są wysyłane bez czekania na odpowiedź, chunki akcji wracają długo żyjącym strumieniem, a oba kierunki przechowują tylko najnowszą wiadomość: zaległości są odrzucane, bo akcje obliczone na podstawie nieaktualnej obserwacji są bezużyteczne. Keepalive wykrywa półotwarte połączenie w ciągu kilku sekund.
Obserwowalny w trakcie działania
W trakcie pracy musimy wiedzieć, co zawiodło, gdzie i w jakim stanie jest system. Wszystko, co opuszcza hosta, przechodzi przez protokół pub/sub o narzucie na tyle niskim, że może działać obok pętli sterowania, przypięty do innego rdzenia. Każdy komponent (sama pętla, każda kamera, wątek robota, rejestrator, klient policy) publikuje swój stan na własnym topiku: obserwowane częstotliwości, liczniki przekroczeń, wiek klatek, latencję inference. Stan przebiegu jest publikowany z odtworzeniem ostatniej próbki, więc dashboard podłączony w środku epizodu od razu widzi bieżący stan. Podglądy z kamer są kodowane do JPEG w wątku roboczym i publikowane na osobnych topikach, dzięki czemu operator, który zdalnie subskrybuje te same topiki, może śledzić epizod bez ingerencji w pętlę.
Wymieniasz proces, nie cały stack
Stack można uruchomić tylko w jeden wspierany sposób, produkcyjny. Wygodę pracy deweloperskiej zapewnia tooling, a nie równoległa ścieżka kodu, a lista zależności jest celowo krótka. Nowa platforma robotyczna, kamera czy backend inference to jeden wymieniony proces, który publikuje te same wiadomości. Dzięki temu robot przepracowuje całą zmianę w działającym magazynie, silnik danych pracuje przez całą dobę, a nowy akcelerator trafia do stacku w ciągu kilku dni.