Benchmarking wizualnego postępu w czasie na potrzeby kuracji danych
(Autorzy)
Paweł Budzianowski
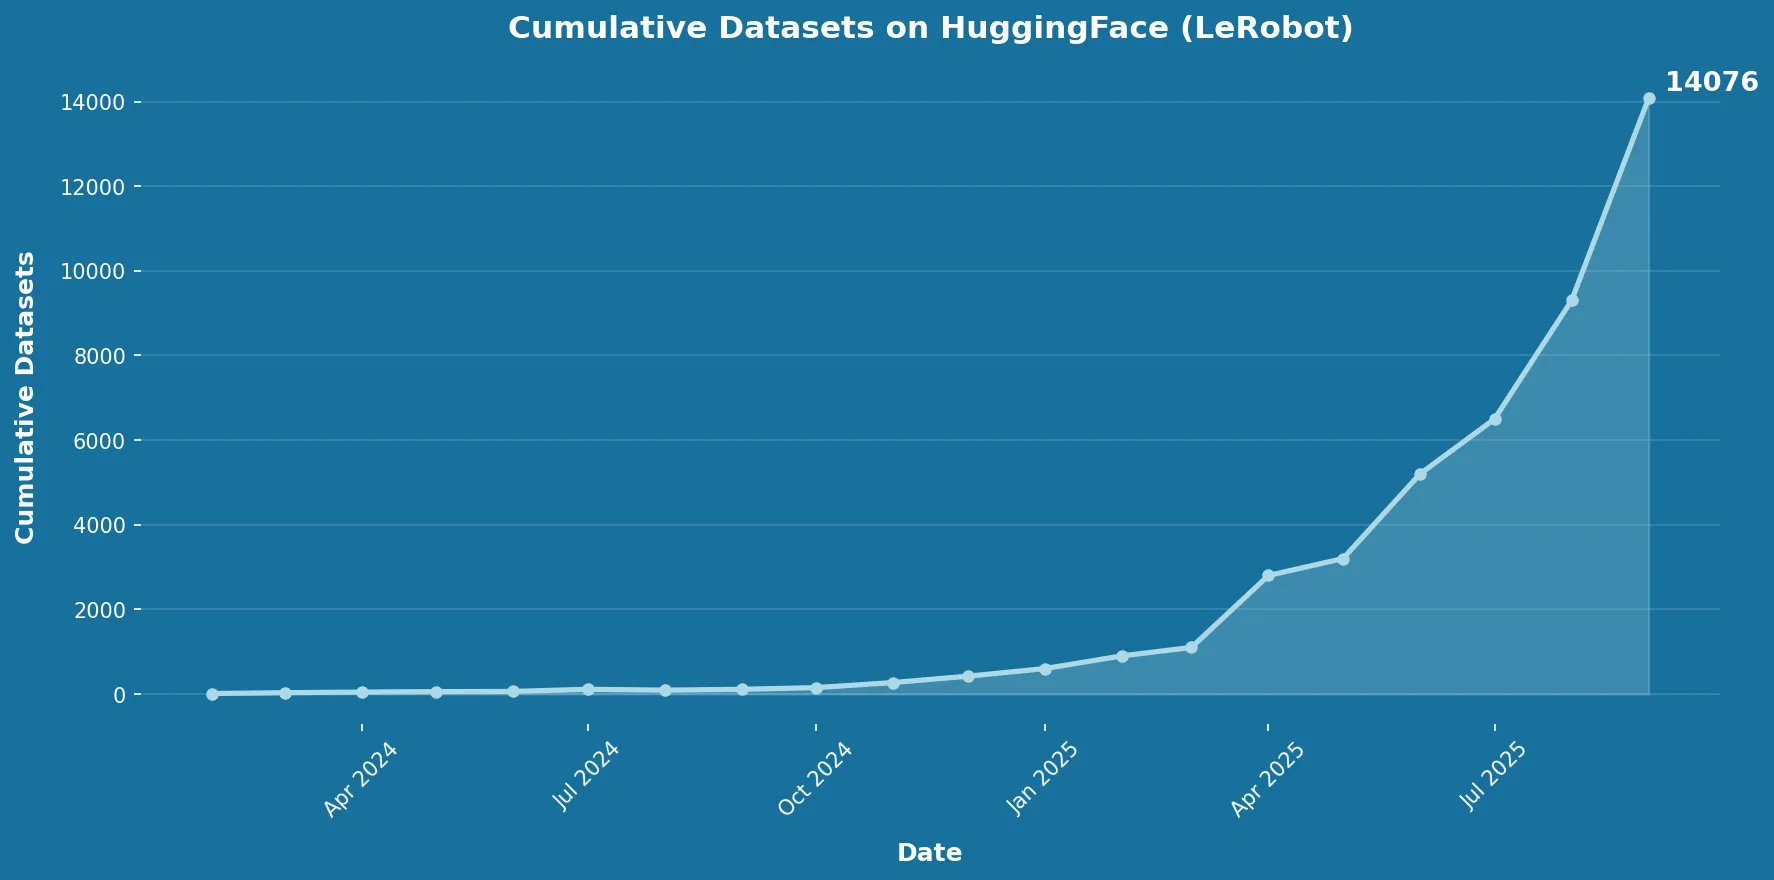
Niedobór danych pozostaje jednym z głównych czynników ograniczających postęp w robotyce. Choć liczba dostępnych zbiorów danych robotycznych rośnie wykładniczo, wyselekcjonowanie z nich danych wysokiej jakości wciąż stanowi poważne wyzwanie. OpenGVL wprowadza kompleksowy benchmark do szacowania postępu w różnorodnych zadaniach manipulacyjnych, wykonywanych zarówno przez roboty, jak i przez ludzi, który umożliwia automatyczną kurację i filtrowanie danych na dużą skalę.
Postęp w czasie i reward modele
Szacowanie postępu w czasie w obrębie trajektorii jest podstawą oceny jakości danych w zbiorach robotycznych. Dla trajektorii celem jest przypisanie wartości skalarnych, które odzwierciedlają, na ile trajektoria osiąga zamierzony cel. Formalnie opisuje to funkcja wartości:
gdzie oznacza sygnał sukcesu zadania w danym kroku czasowym, a to współczynnik dyskontowania. W praktyce rzeczywiste (ground truth) sygnały nagrody są rzadko dostępne, dlatego trzeba polegać na wyuczonych lub heurystycznych estymatorach postępu. Modele vision-language (VLM) są tu obiecującym rozwiązaniem, bo mogą wykorzystać szerokie rozumienie wizualne i semantyczne do przewidywania ukończenia zadania bezpośrednio z surowych obserwacji obrazowych, bez projektowania nagrody pod konkretne zadanie.
Generative Value Learning
Generative Value Learning (GVL) to podstawowa metoda, na której opiera się OpenGVL. Podejście wykorzystuje wiedzę zawartą w pretrenowanych modelach vision-language do przewidywania postępu zadania bezpośrednio z obserwacji wizualnych. Model VLM otrzymuje zestaw przetasowanych klatek pobranych z trajektorii i ma przypisać każdej z nich procent ukończenia, który odzwierciedla, jak daleko zadanie posunęło się w danym momencie.
Jakość tych przewidywań mierzy się metryką Value-Order Correlation (VOC), która oblicza korelację rang Spearmana między przewidzianymi wartościami ukończenia a rzeczywistą kolejnością czasową klatek :
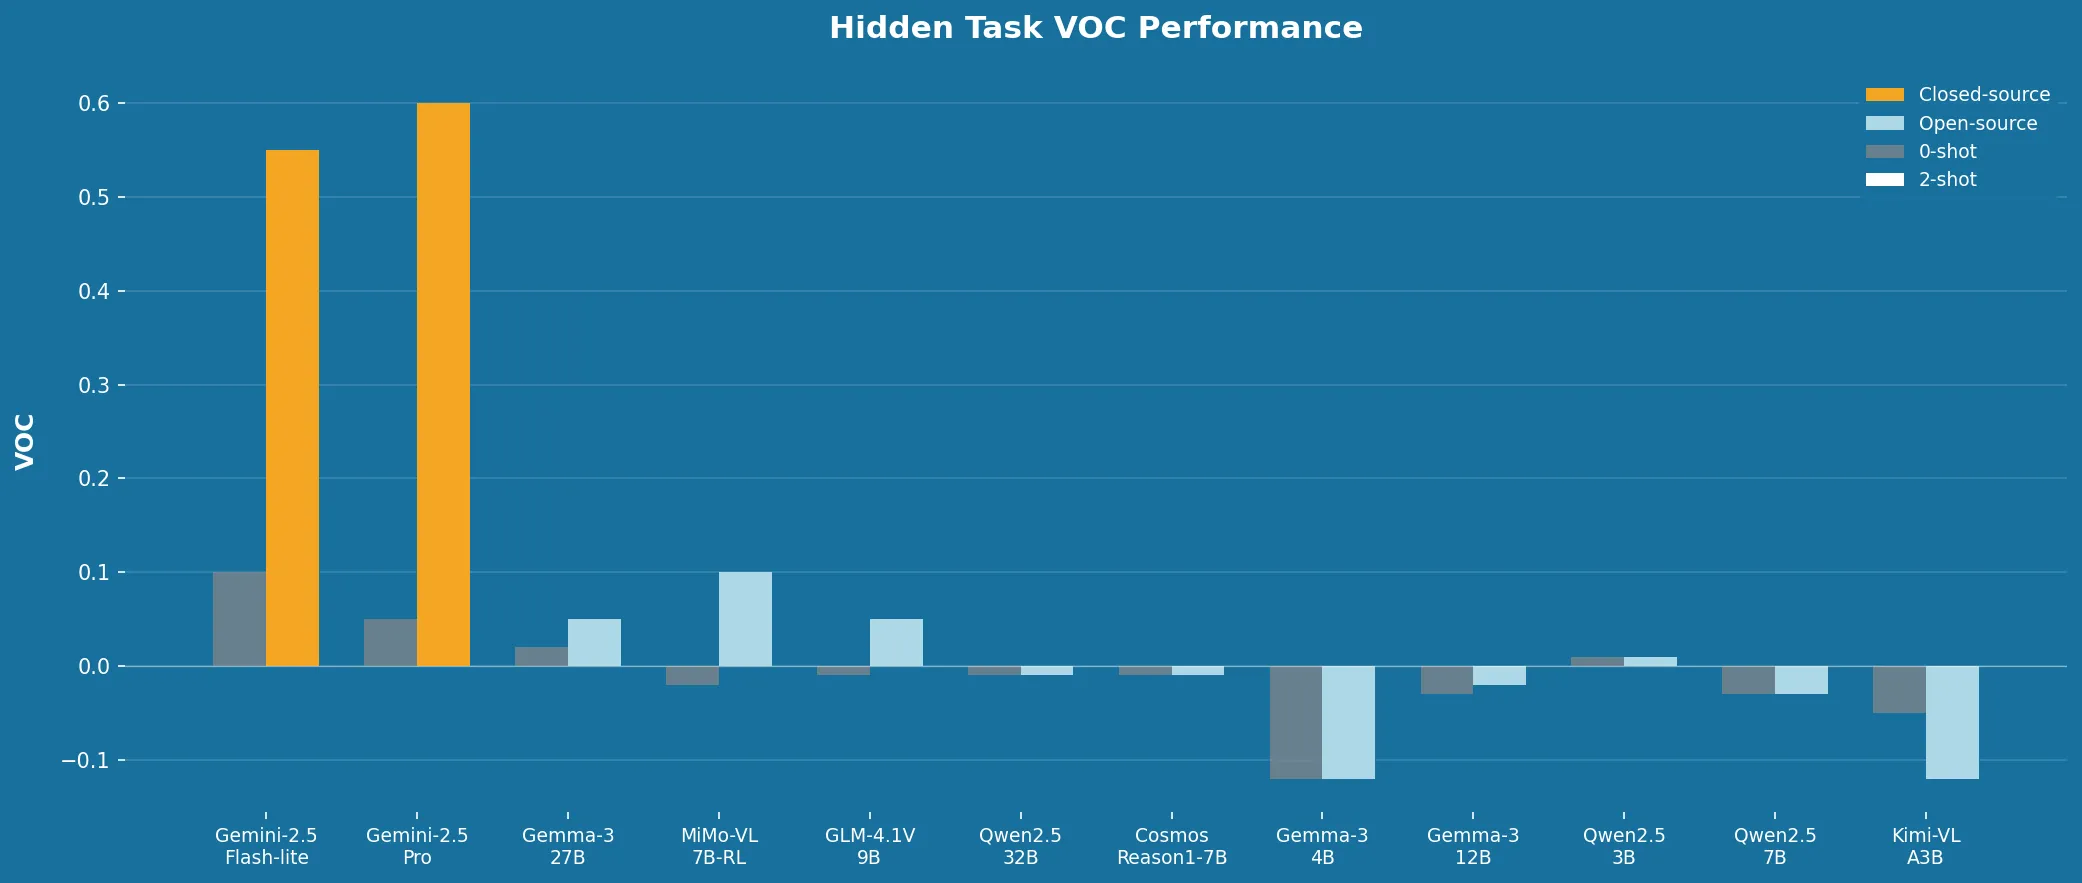
gdzie to różnica między przewidzianą rangą a rzeczywistą rangą czasową klatki . VOC przyjmuje wartości od (idealna korelacja odwrotna) do (idealna zgodność czasowa). Wysoki VOC oznacza, że model potrafi poprawnie odróżnić klatki z wczesnych etapów od klatek z późnych etapów, nawet gdy obrazy są podane w losowej kolejności. Benchmark ocenia modele w dwóch trybach warunkowania: zero-shot, w którym model otrzymuje tylko przetasowane klatki ewaluacyjne i opis zadania, oraz two-shot, w którym jako odniesienie podaje się dodatkowo dwa uporządkowane epizody kontekstowe ze znanymi etykietami postępu.
Modele zamknięte i open source
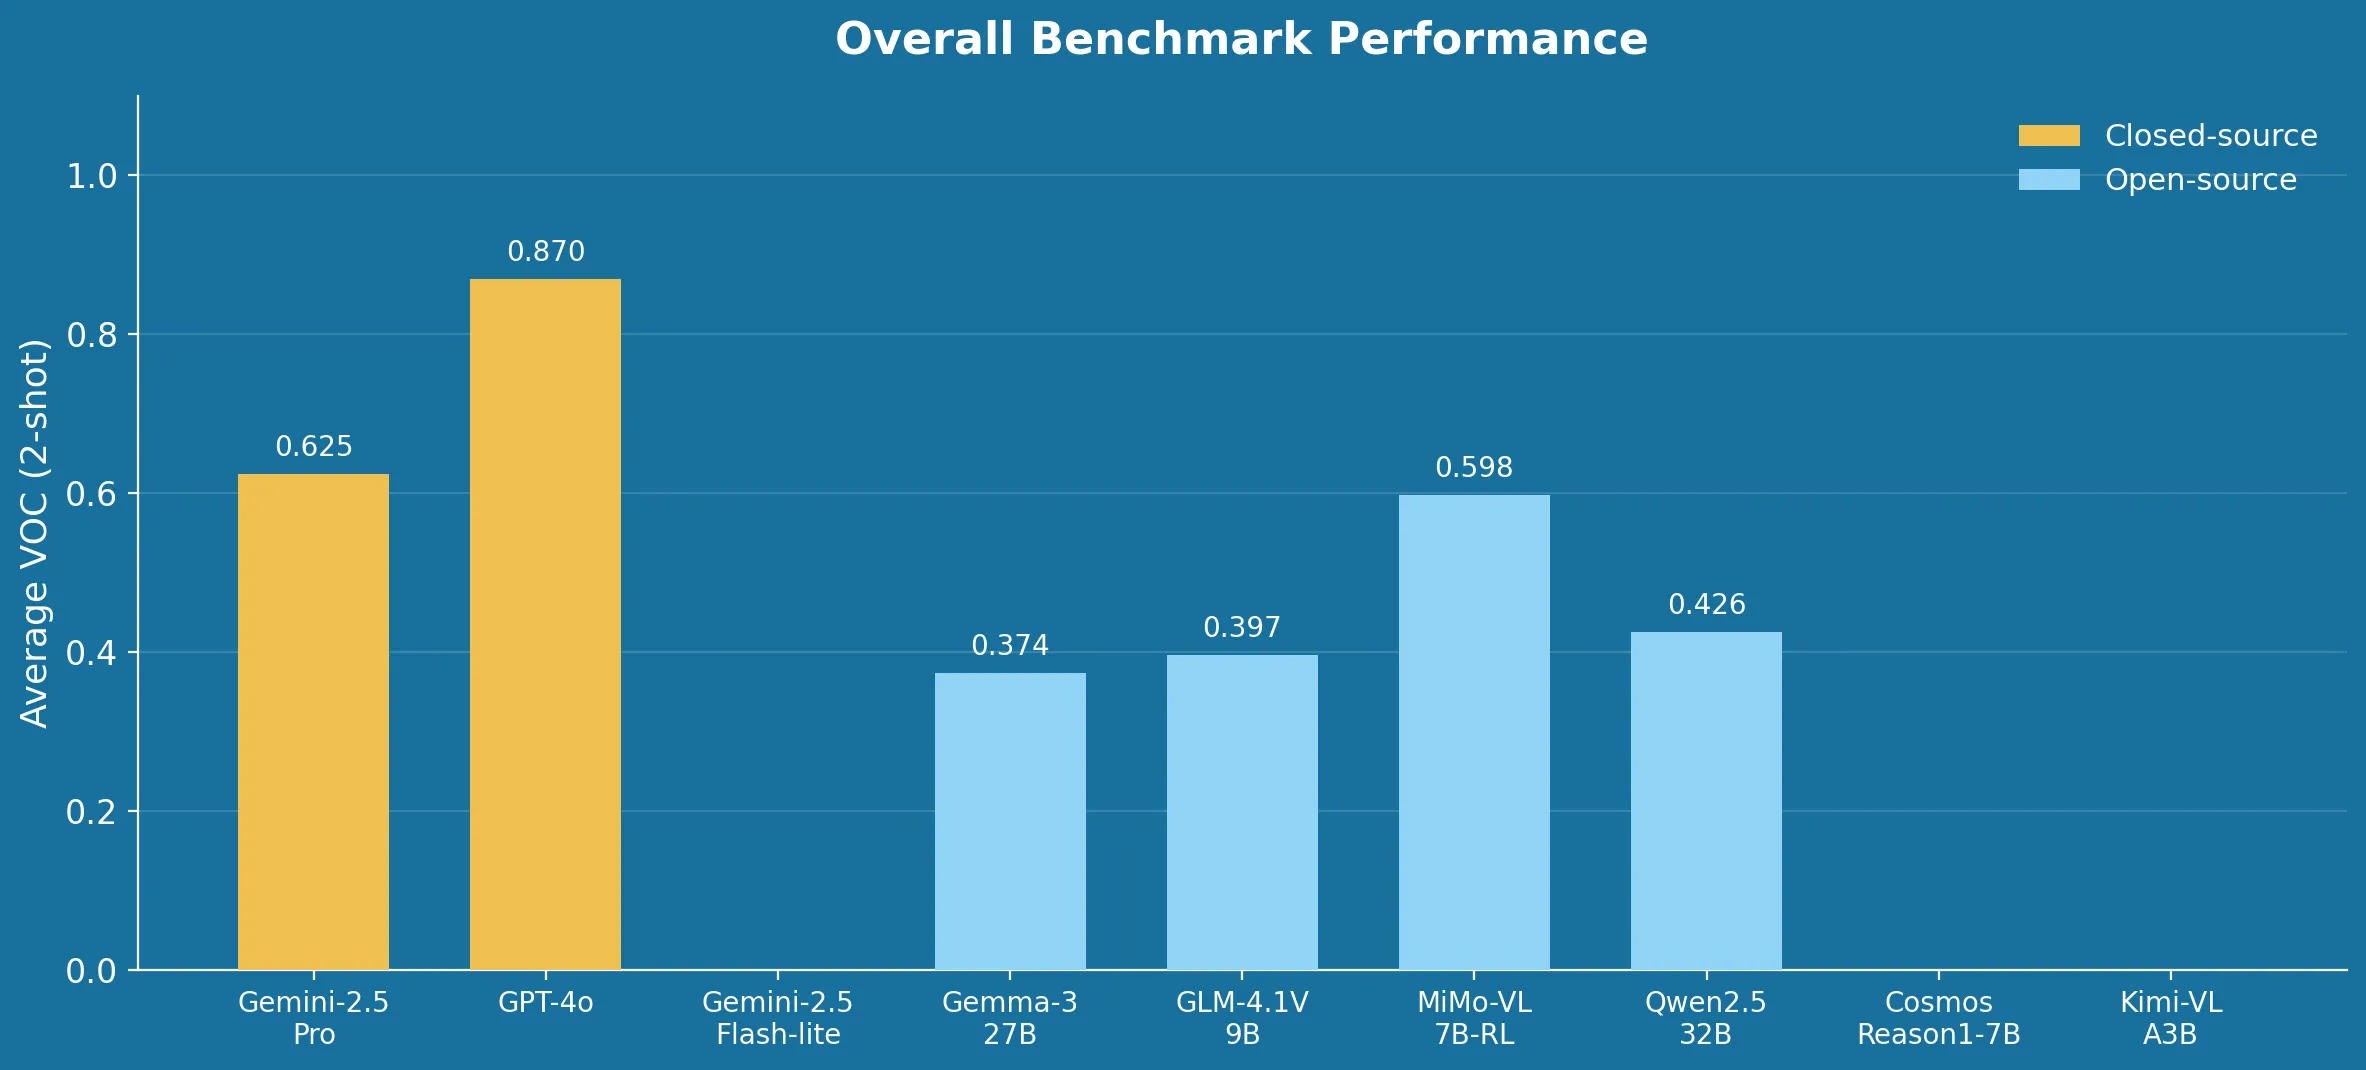
OpenGVL ocenia szeroki zakres modeli vision-language, zarówno zamkniętych, jak i open source. Punktem odniesienia wśród modeli zamkniętych są Gemini-2.5-Pro, Gemini-2.5-Flash-lite i GPT-4o. Po stronie open source benchmark testuje rodzinę Gemma-3 (4B, 12B, 27B parametrów), rodzinę Qwen2.5-VL (3B, 7B, 32B parametrów) oraz kilka modeli zdolnych do rozumowania (reasoning), w tym GLM-4.1V-9B, MiMo-VL-7B-RL, Cosmos-Reason1-7B i Kimi-VL-A3B.
Główny wniosek jest jednoznaczny: rodziny modeli open source wyraźnie ustępują swoim zamkniętym odpowiednikom i w przewidywaniu postępu w czasie osiągają tylko około 70% ich wyników. Ta różnica utrzymuje się we wszystkich zbiorach danych i typach zadań, co podkreśla obecne ograniczenia otwartych VLM w zadaniach wymagających rozumowania przestrzennego i czasowego, istotnych dla robotyki.
Wyniki benchmarku
Benchmark zbudowano na czterech uznanych zbiorach danych robotycznych: nyu_door, berkeley_mvp, cmu_stretch i nyu_franka. Z każdego zbioru losuje się 50 epizodów, po losowych klatek na epizod, przetasowanych na potrzeby ewaluacji. Z wyników wyłania się kilka spójnych wzorców:
Na zbiorze nyu_door Gemini-2.5-Pro osiąga VOC 0,9158 (zero-shot) i 0,9654 (two-shot), podczas gdy najlepszy model open source, GLM-4.1V-9B, uzyskuje odpowiednio tylko 0,6420 i 0,6540. Gemma-3-27B osiąga 0,6372 (zero-shot) i 0,8219 (two-shot), co pokazuje wyraźną poprawę dzięki warunkowaniu few-shot. Na trudniejszym zbiorze berkeley_mvp różnica jeszcze rośnie: Gemini-2.5-Pro uzyskuje 0,5626 / 0,6806, Gemma-3-27B tylko 0,1427 / 0,1575, a Qwen2.5-32B 0,2491 / 0,2426.
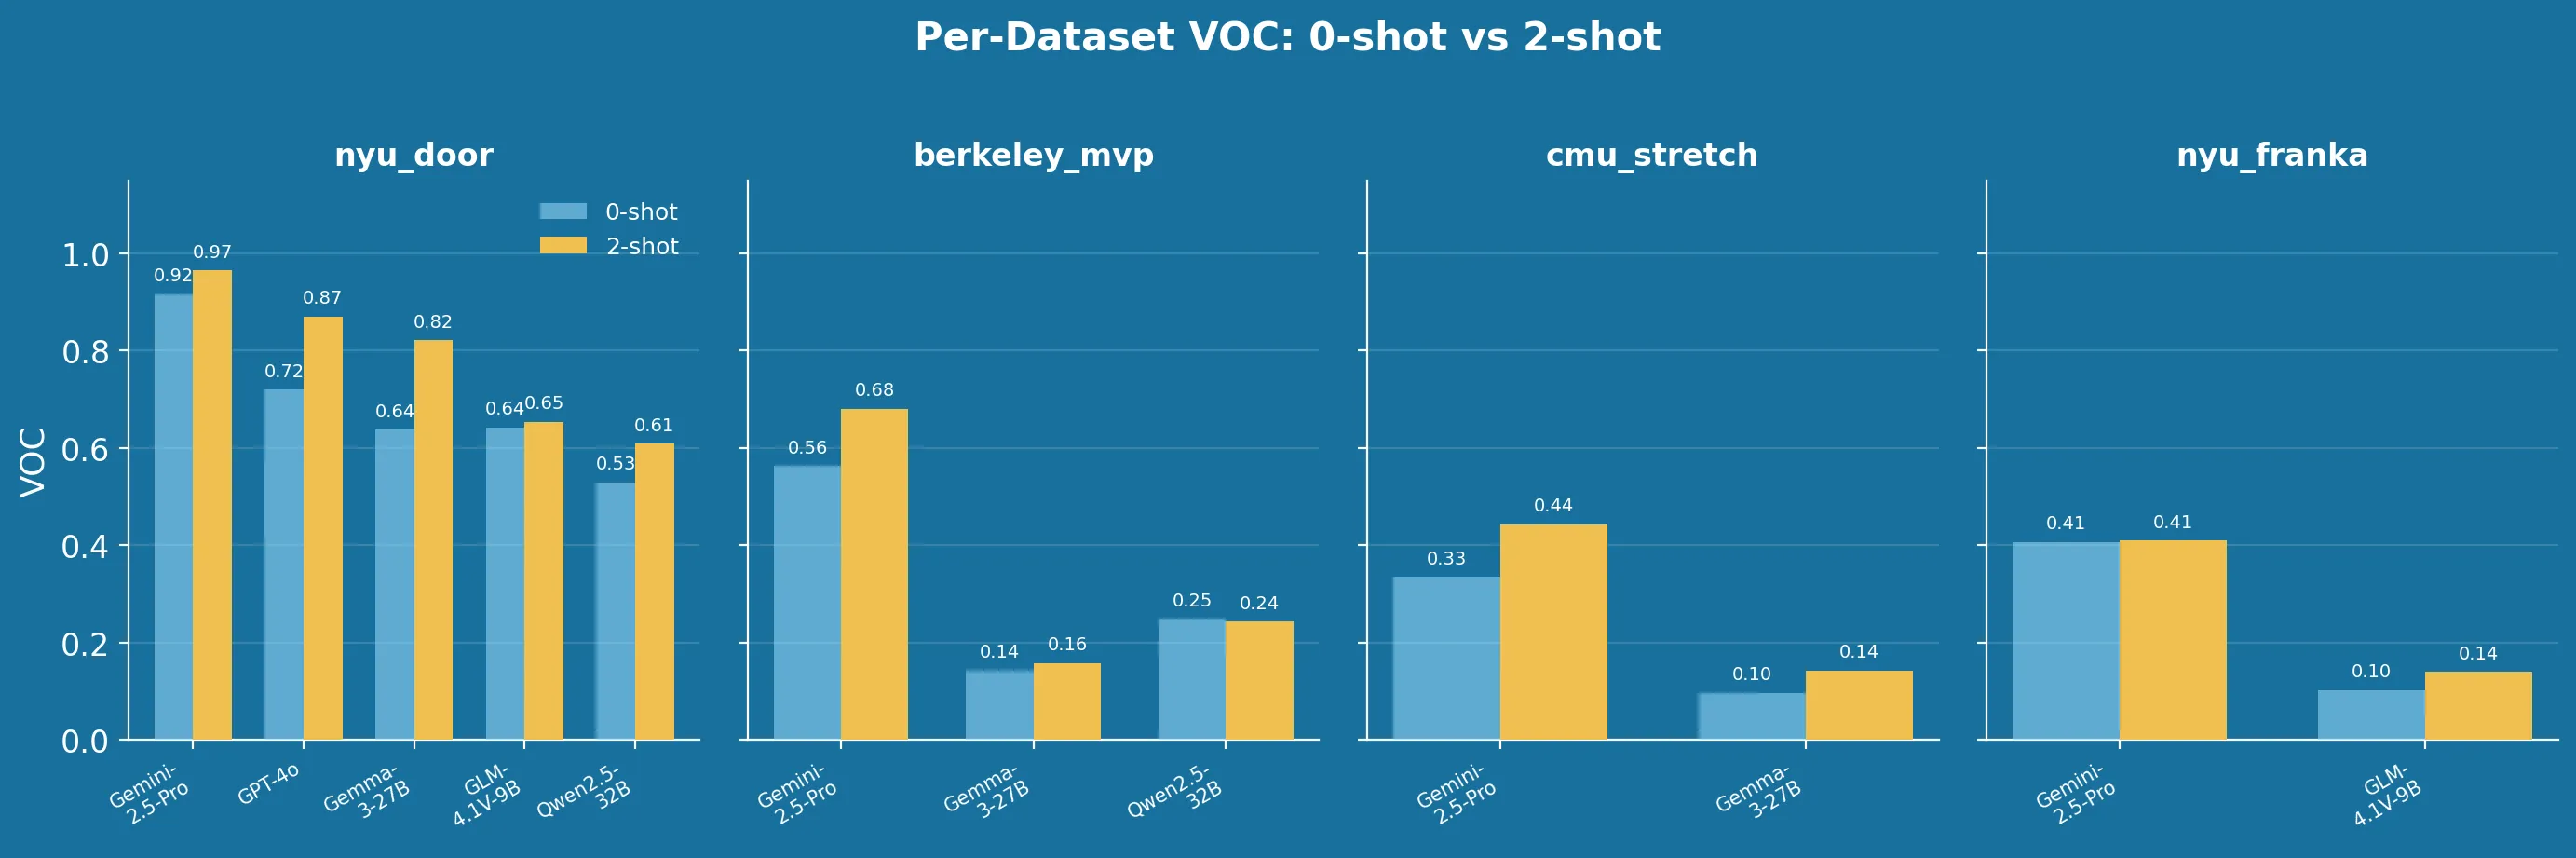
Wyniki na cmu_stretch i nyu_franka potwierdzają ten trend. Prowadzi Gemini-2.5-Pro z wynikami 0,3348 / 0,4427 na cmu_stretch i 0,4065 / 0,4099 na nyu_franka, a najmocniejsze alternatywy open source pozostają daleko w tyle. W obrębie rodzin modeli skala konsekwentnie poprawia wyniki: większe warianty wypadają lepiej od mniejszych. Spośród modeli open source zdolnych do rozumowania najlepsze wyniki osiąga MiMo-VL-7B-RL, a Kimi-VL-A3B nie spełnia oczekiwań.
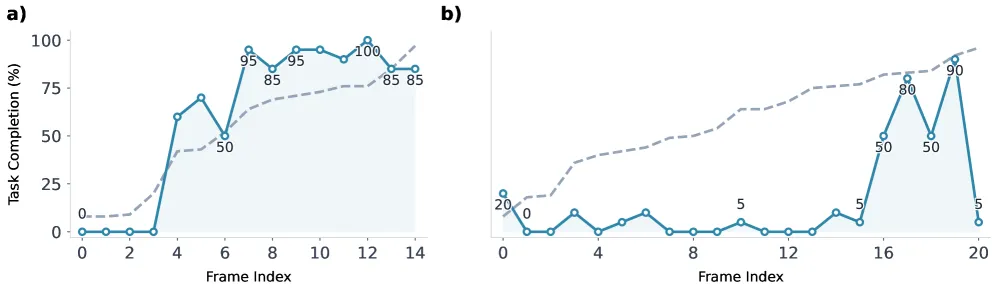
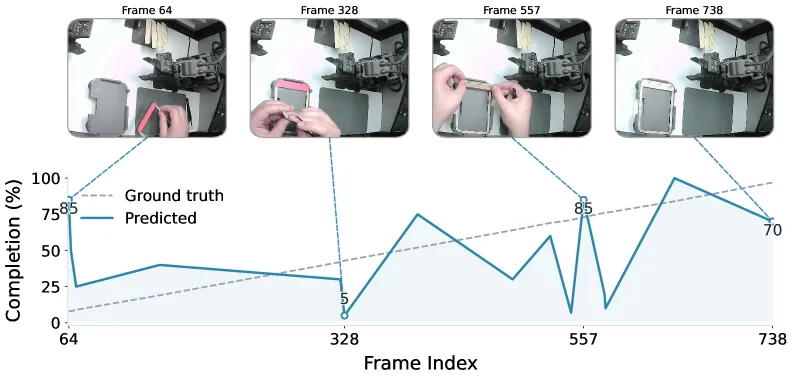
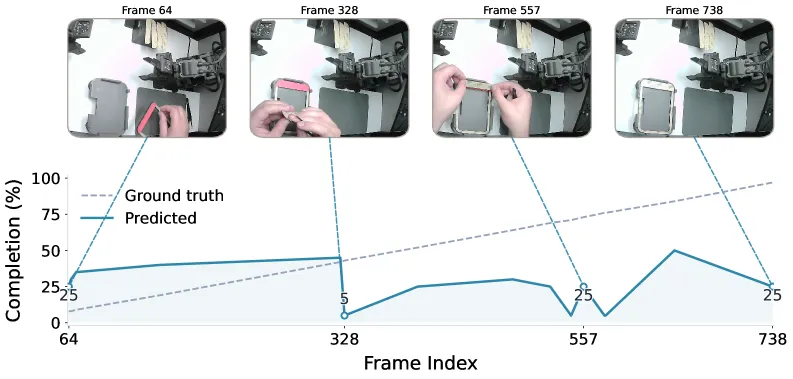
Poza oceną modeli OpenGVL identyfikuje za pomocą swojego pipeline’u kuracji trzy kategorie problemów z jakością zbiorów danych: niejednoznaczność definicji zadania, gdy instrukcje są niejasne, a metryki ukończenia zachowują się wbrew intuicji; niejednoznaczność etykiet, gdy instrukcje zadania są zbyt ogólnikowe, by ustalić właściwe zależności czasowe; oraz epizody spoza rozkładu (out-of-distribution), gdy odstające trajektorie wykazują nieregularne wzorce postępu, które mogą zakłócić dalszy trening modeli.
Ranking OpenGVL
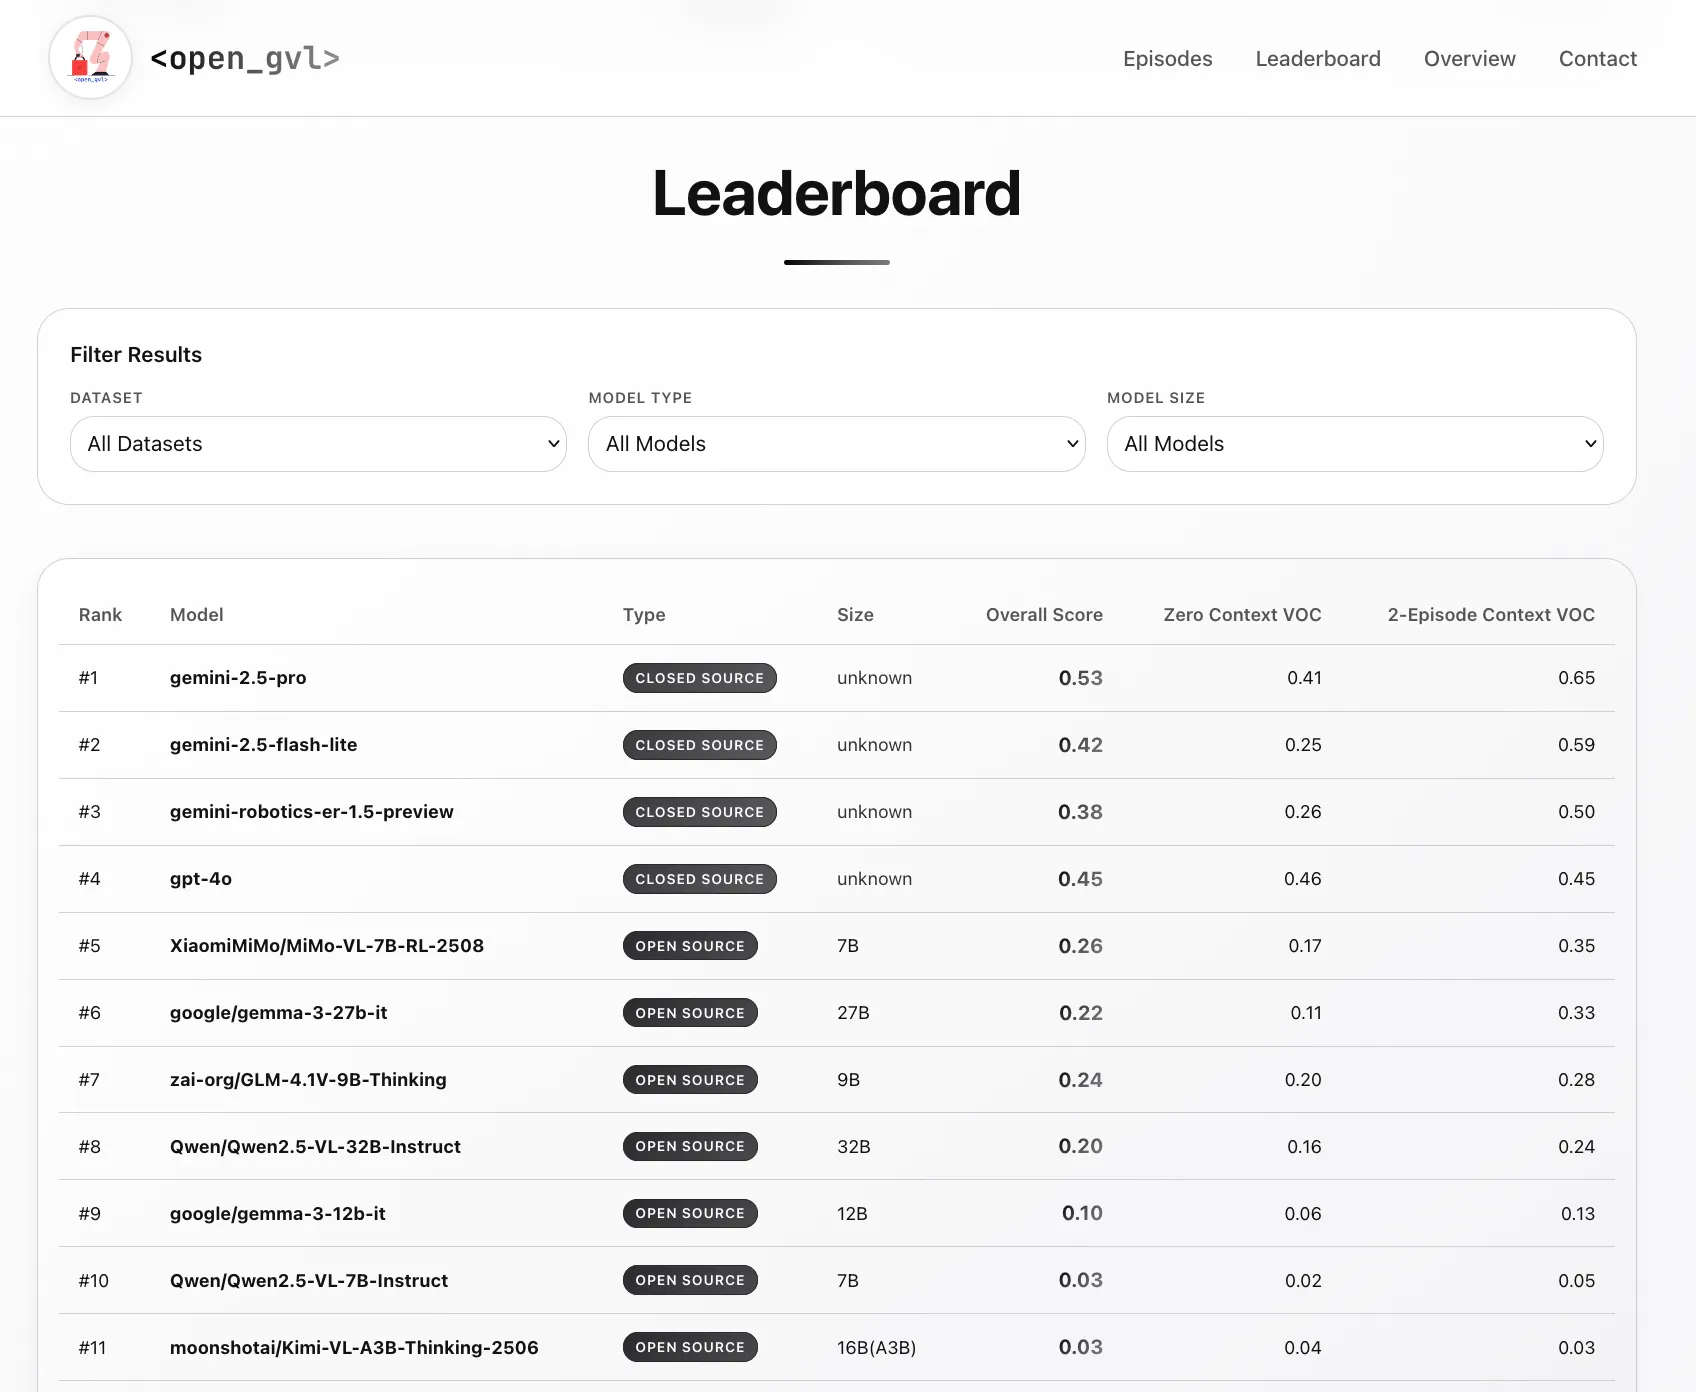
Praca została zaprezentowana podczas Workshop on Making Sense of Data in Robotics na CoRL 2025. Ranking jest dostępny pod adresem huggingface.co/spaces/OpenGVL/OpenGVL, a pełny kod i benchmark są publicznie dostępne na github.com/budzianowski/opengvl. Wszystkie modele oceniono przy temperaturze , z jednym szablonem promptu systemowego, na trajektoriach próbkowanych równomiernie z demonstracji eksperckich.
Cytowanie
Prosimy cytować tę pracę w następujący sposób:
@article{budzianowski2025opengvl,
  author  = {Budzianowski, Pawe{\l} and Wi{\'s}nios, Emilia and G{\'o}ral, Gracjan and Kulakov, Igor and Petrenko, Viktor and Walas, Krzysztof},
  title   = {OpenGVL -- Benchmarking Visual Temporal Progress for Data Curation},
  journal = {Workshop on Making Sense of Data in Robotics at CoRL},
  year    = {2025},
  note    = {\url{https://arxiv.org/abs/2509.17321}},
}