Od szumu do użytecznego sygnału
(Autorzy)
Paweł Budzianowski, Kobi Kelemen
Skalowanie zbierania danych to wyczyn sam w sobie, niezależnie od tego, jak się je zbiera. W Lute zbieramy dane przez całą dobę, w różnych środowiskach i na różnych platformach sprzętowych. Każdy sprzęt ma swoje dziwactwa, każdy teleoperator ma własny styl ruchu, a każdy anotator ma własne wyczucie przy etykietowaniu. Po dodaniu ogólnych nagrań ludzkich czynności zbieranych na potrzeby pre-trainingu każdego dnia gromadzimy ogromną ilość danych, ale z dużym szumem. W tym wpisie pokazujemy, jak budujemy zestaw metryk jakości, aby stale poprawiać jakość danych i skuteczność finalnych policy w wymagających problemach z realnego świata, którymi zajmujemy się wspólnie z naszymi partnerami produkcyjnymi.
Rozwiązywanie realnych problemów: współpraca z iBombo
iBombo to światowy lider w produkcji stacji naprawy rowerów i solarnych stacji ładowania, z ponad 24 000 stacji w 45 krajach. Każda stacja ma kilka narzędzi do pompowania lub wymiany opon, wymiany dętek i regulacji przerzutek. Stacje wytrzymują trudne warunki pogodowe i są zaprojektowane tak, by każdy mógł z nich korzystać w dowolnym miejscu. Wytwarzanie niestandardowych części wymaga dużo pracy ręcznej, zręczności i precyzji. iBombo nawiązało współpracę z Lute, aby zautomatyzować ten pracochłonny, ręczny proces produkcji.
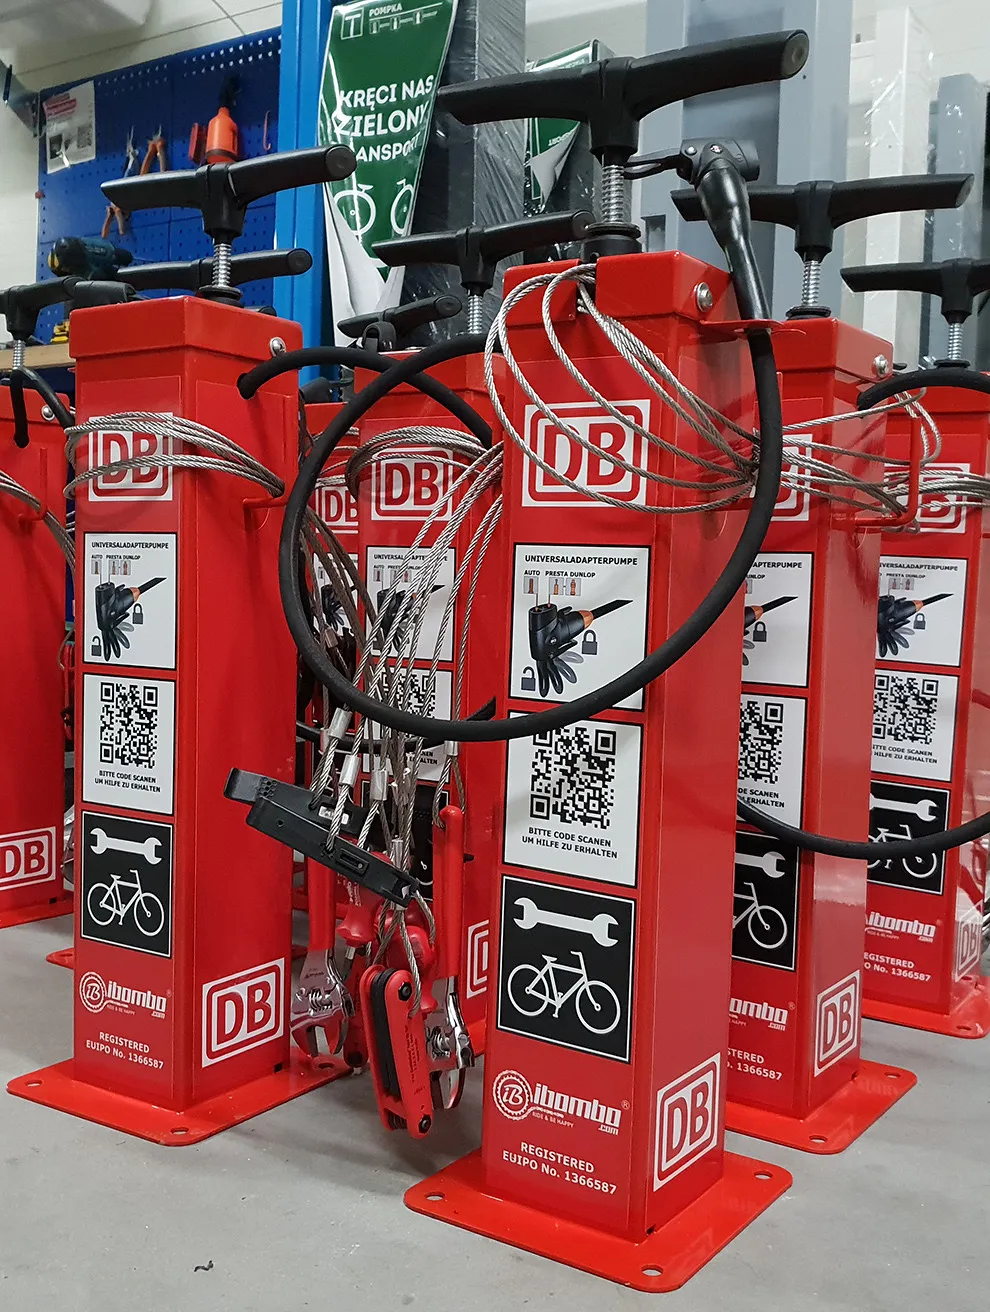
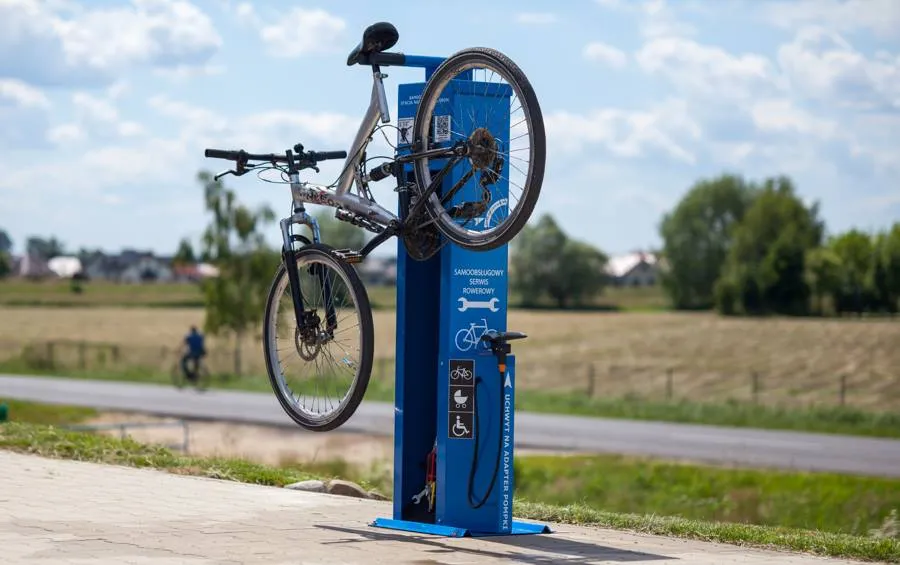
Budując wspólnie zautomatyzowany proces, zidentyfikowaliśmy kilka podzadań, które wystawiają na próbę granice zręczności naszej technologii i sprzętu.
Proste, a jednak wymagające zadania
Przykładem takiego podzadania jest przewlekanie drutu przez rurkę z tworzywa wzmocnionego włóknem z precyzją poniżej milimetra. Przedstawiliśmy to wyzwanie na naszym ostatnim hackathonie: uczestnicy dostali prawdziwe komponenty używane na hali produkcyjnej, skalibrowane dane w sprawdzonym środowisku i dużą moc obliczeniową. Środowisko ewaluacyjne pozwalało odtworzyć zachowanie zarejestrowane podczas zbierania danych. Wiele zespołów przygotowało mocne baseline’y, testując szeroki wachlarz pomysłów, od inspekcji danych i rozmieszczenia komponentów po podejścia oparte na reward modelu. Typowa policy zachowuje się jednak tak:
Błędy policy wynikają z nawarstwiania się różnych artefaktów, które często trudno od siebie oddzielić i prześledzić.
Szukanie zgniłych jabłek
Zbieranie danych na dużą skalę prowadzi do najróżniejszych problemów z ich jakością. Niektóre są oczywiste, jak niedokończone zadania albo zadania wyraźnie wykonane niezgodnie z zamierzeniem:
Po odfiltrowaniu oczywistych przypadków zostają znacznie subtelniejsze problemy, które trudniej wykryć. Eksploracja i analiza danych w naturalny sposób prowadzi do zestawu filtrów jakości, które niezawodnie oddzielają dobre epizody od złych. Każdy filtr zweryfikowaliśmy na dwóch zbiorach danych (czystym zbiorze bazowym i zbiorze mieszanym, zawierającym epizody, o których wiadomo, że pogarszają trening policy), mierząc, jak selektywnie filtr trafia w złe dane, nie odrzucając dobrych demonstracji. Główną miarą jest współczynnik selektywności: ile złych danych filtr wyłapuje w stosunku do tego, ile dobrych danych usuwa. Filtr, który odrzuca dwa razy więcej złych epizodów niż dobrych, ma współczynnik 2x; im wyższy, tym lepiej. Wszystko poniżej 1x aktywnie szkodzi, bo usuwa więcej dobrych danych niż złych. Przedstawiamy dwa filtry, które sprawdzają się na naszym stanowisku do zbierania danych i powinny przydać się także w innych projektach.
Filtr nieciągłości
Jeden z naszych kluczowych sygnałów wykrywa nagłe skoki w przestrzeni akcji między kolejnymi klatkami. Złe epizody zawierają pojedyncze duże skoki, typowe dla błędów teleoperacji lub zakłóceń sygnału: wektor akcji w jednej klatce gwałtownie się przesuwa, po czym wraca do normy. Wielkość pojedynczych skoków znacznie lepiej odróżnia epizody niż ich częstość: złe epizody skaczą mocno, a nie często. Ten filtr osiąga wysoki współczynnik selektywności, wyłapując znaczną część złych epizodów i w dużej mierze nie naruszając dobrych demonstracji.
| Próg | Odrzucone dobre | Odrzucone dodatkowe | Stosunek |
|---|---|---|---|
| 0,15 | 63,0% | 82,0% | 1,3x |
| 0,20 | 28,8% | 53,9% | 1,9x |
| 0,25 | 10,8% | 27,5% | 2,5x |
| 0,30 | 4,3% | 15,3% | 3,6x |
| 0,40 | 0,4% | 3,0% | >7x |
| 0,50 | 0,2% | 1,2% | >6x |
Filtr zmienności
Ten filtr mierzy, na ile wariancja akcji każdego przegubu w obrębie epizodu odbiega od wartości typowej dla czystych danych. Złe epizody wykazują nienaturalnie wysoką wariancję skupioną w przegubach nadgarstka i chwytaka, co wskazuje na chaotyczne lub niespójne ruchy operatora, ograniczone do precyzyjnej manipulacji, a nie do ogólnego ruchu ramienia. Normalizacja względem czystego zbioru bazowego sprawia, że filtr jest odporny na różnice między sesjami nagraniowymi.
| Współczynnik skalowania | Odrzucone dobre | Odrzucone dodatkowe | Stosunek |
|---|---|---|---|
| 1,2 | 59,7% | 78,7% | 1,3x |
| 1,5 | 13,8% | 31,5% | 2,3x |
| 1,8 | 3,2% | 12,9% | 4,0x |
| 2,0 | 1,3% | 5,1% | 4,0x |
| 2,5 | 0,2% | 0,0% | — |
Kilka innych heurystyk wyglądało obiecująco w teorii, ale na naszym stanowisku zwykle nie dawało użytecznego sygnału. Test płynności oparty na zrywie (jerk) akcji zawodzi, bo pojedyncze skoki uśredniają się na przestrzeni setek klatek: według tej miary dobre i złe epizody wyglądają na równie płynne. Test czasu bezczynności nie znajduje istotnych przerw w żadnej z grup; operatorzy są aktywni przez cały czas. Test aktywności chwytaka wręcz szkodzi, wyłapując więcej dobrych epizodów niż złych, bo celowe chwytanie świadczy o jakości, a nie o wadzie. Długość epizodu i pokrycie przestrzeni roboczej nie wykazują w tym zadaniu korelacji z jakością.
Reward model i postęp w czasie
Wcześniej sprawdzaliśmy, jak pretrenowane modele bazowe (foundation models) mogą pełnić rolę kuratorów danych, wykrywając brak lub zaburzenie postępu w funkcji wartości. Trenując nasz wielkoskalowy model robotyczny LEM, widzimy też pierwsze oznaki generalizacji w szacunkach nagrody z wczesnej wersji modelu. Ponieważ jest on trenowany na ponad 20 tys. godzin danych robotycznych z różnych platform oraz na danych ludzkich, już teraz pozwala szybko wskazać podejrzane epizody, których bardziej deterministyczne reguły nie wykryją, bo brakuje im kontekstu wizualnego. Oto kilka przykładów, w których wczesna wersja wariantu LEM-RM wyłapuje błędne epizody:
Po lewej widać, jak reward model wychwytuje nieudany epizod: podczas przesłonięcia sygnał nagrody chwilowo rośnie, a zaraz potem zostaje skorygowany. Przykład po prawej pokazuje stały postęp aż do osiągnięcia celu w zupełnie nowym zadaniu.
Zachowania emergentne
Gdy wszystkie te zabezpieczenia są na miejscu, filtrowanie danych staje się ustandaryzowane i bardzo niezawodne, co pozwala stale dodawać kolejne dane na dużą skalę i podejmować różne zadania. To znacznie przyspiesza cykl iteracji zarówno w eksperymentach badawczych, jak i w modelowaniu danych. Pokazuje też piękno i staranność ludzkich ruchów przenoszonych na zachowanie modelu. Poniższy przykład pokazuje, jak nasza technologia może nadać ludzki charakter skądinąd monotonnym ruchom robota.
Jeśli pracujesz nad poprawą jakości danych lub policy dla swoich robotów, chętnie o tym porozmawiamy! Napisz do nas na contact@lute.one.